PR:https://github.com/oceanbase/powercontext/pull/1446
PowerContext 的既有后台运行时依赖 APScheduler,调度状态存放在一个 SQLite sidecar 文件中。Memory 激活、Experience 孵化这类需要调用外部模型服务的任务,都由这个进程内调度器触发。
这次改造把 API 层扩展为多副本。原有架构中有三处状态绑定在单个进程上。调度状态在 SQLite 文件中,其他进程无法读取。handler 注册表在进程内存中,工作只能由发起它的进程执行。MCP 会话状态同样在内存中,客户端连续两次请求路由到不同副本即会失败。对应到部署层面,后果是明确的。副本 A 受理的 flush,副本 B 无法查询进度。MCP 流量必须依赖负载均衡器的会话亲和。调度器无法做主备,因为选主状态和扫描进度无法跨进程共享。
备选方案及其否决理由
设计阶段的大部分工作在论证不做什么。
最直接的方案是引入 Redis 或 Kafka 承担队列职责。我没有采纳。系统会因此出现第二个持久化事实源,队列确认投递与数据库落账之间没有分布式事务,两者之间的不一致窗口只能依靠应用层对账弥补。当前吞吐量尚不需要消息中间件,引入它意味着提前承担跨系统一致的成本。
第二个候选是 MySQL 的 GET_LOCK()。它是会话作用域的锁。连接池环境下,同一条连接会被不同的逻辑持有者复用,它不能提供 fencing 所需的互斥保证。
第三个候选是抽象一套公开的 Queue/Coordinator SPI,允许社区接入其他后端。在第二个实现尚不存在时冻结协调语义的接口边界,大概率会抽象出错误的边界。
最后一个被否决的方案,是让单机模式继续运行 APScheduler,分布式模式另走一套新协议。系统中会长期并存两套执行与恢复语义,并在重试时机、崩溃行为等细节上逐渐分叉,每一处分叉都转化为测试与排障成本。最终默认的单机部署同样运行在新协议上,只是全部角色共处于同一进程。
剩下的路径只有一条。OceanBase 作为分布式执行唯一的协调与持久化权威,工作状态、租约、游标、领域提交全部由数据库持有。全系统只需理解和验证一套协议。
Work Ledger 的表结构
账本没有采用单一队列表的建模。队列语义被拆分为若干相互正交的概念,每个概念一张表。
| 表 | 职责 |
|---|---|
| pc_work_items | 工作本体,版本化 payload、状态、lane 序号、租约、尝试预算、脱敏后的结果与错误分类 |
| pc_work_attempts | 只追加的尝试审计,每次执行的 owner、fence、起止时间、结局和 trace 标识 |
| pc_work_lanes | 每条 lane 的序号分配器和队头指针 |
| pc_work_keys | 逻辑窗口的唯一占位,负责去重 |
| pc_scheduler_leases | 调度器选主,单调 fence 加数据库时间过期 |
| pc_scheduler_scans | 每个发现器的持久化 keyset 续扫位置 |
| pc_runtime_members | 各进程的角色和兼容性广告 |
| pc_rate_limit_windows | 可选的跨副本固定窗口限流计数器 |
工作的状态机被压缩到最小规模。
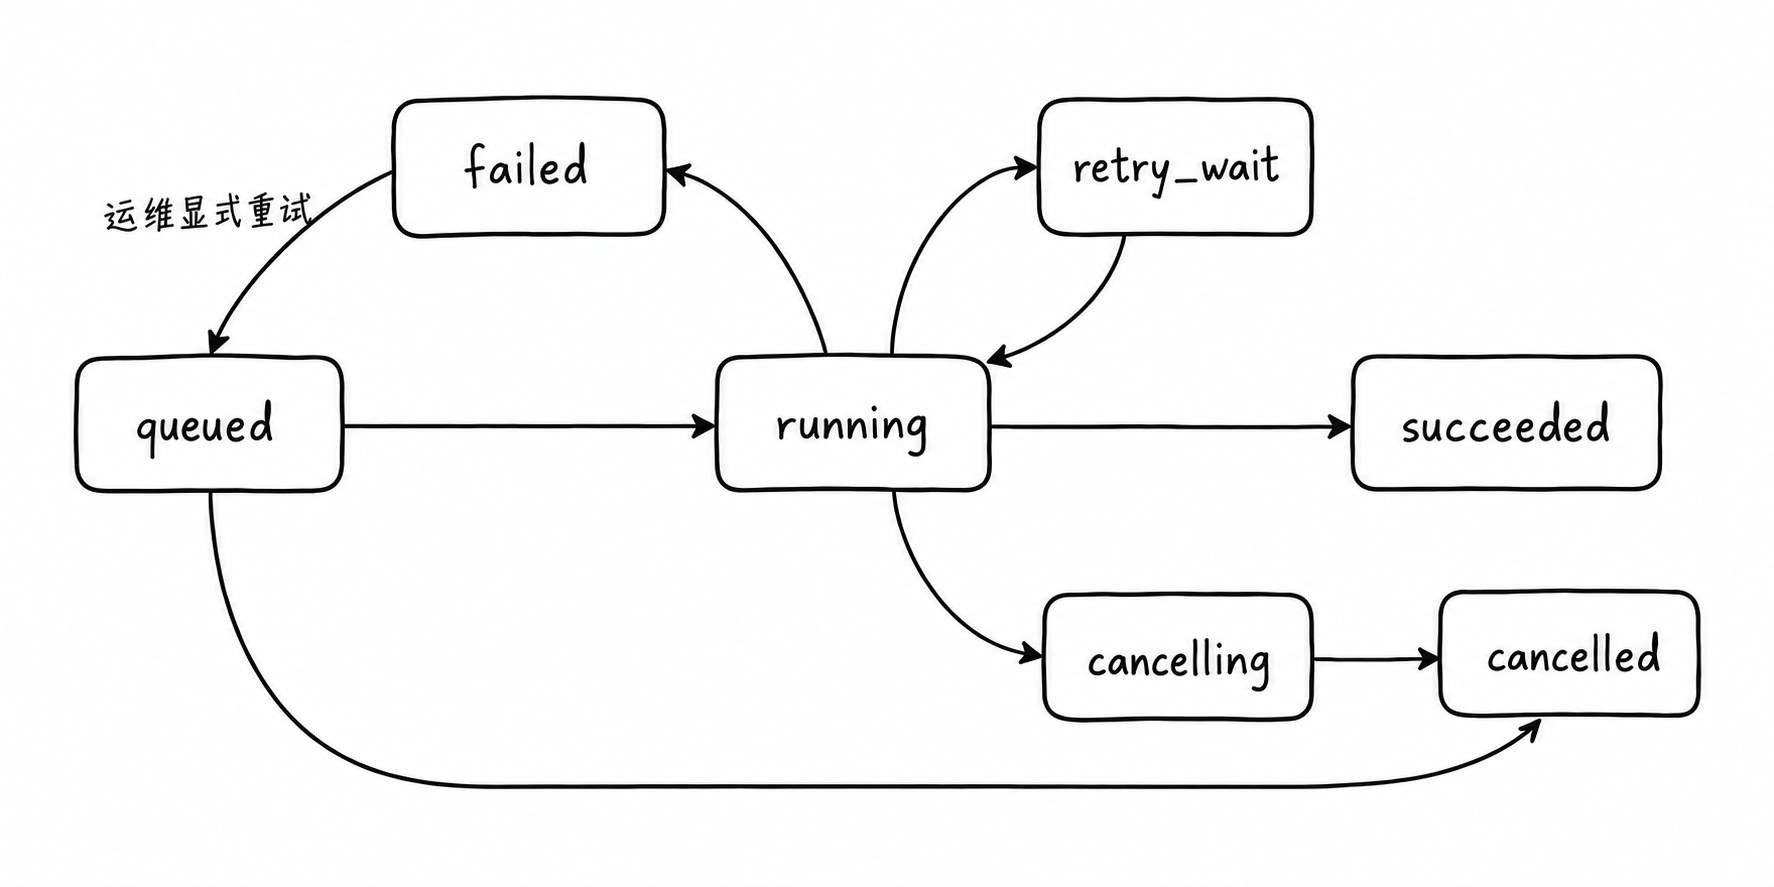
状态较少是刻意的。系统的复杂度被显式转移到数据库约束、锁序与 fencing 协议上。状态机越小,每个状态迁移的并发语义越可以逐条推理、逐条测试。
逻辑键去重
Memory 窗口的逻辑键是一段 SHA-256,摘要输入包含五项,handler 类型、scope、游标名、游标代际、当前游标位置。
logical_key = _digest(json.dumps(
    [kind, scope_id, payload.cursor_name, payload.cursor_generation, payload.after],
    separators=(",", ":"),
))
这里有一项需要说明的取舍。入队时刻的高水位与窗口上界 through 不参与摘要。效果是,用户手动触发的 flush 与调度器的周期性扫描会计算出同一个键,只要两者面对的是同一个尚未推进的游标窗口。键相同,就会在 pc_work_keys 的唯一约束上合并,后到者获得既存工作,入队返回 created=False。窗口上界由首个入队者确定并记入 payload,其后到达的 Source 归属下一个窗口,不会混入正在执行的窗口。
该性质同时覆盖了崩溃恢复。Scheduler 在扫描中途崩溃后重扫同一页是安全的,入队操作幂等。逻辑键的占位保留至工作终态。失败的工作持续持有自己的键,等待运维显式重试或取消。一个无法执行的窗口既不会被无限重建,也不会被静默丢弃。
lane 内的严格顺序
每条工作属于一条 lane,例如 memory:{scope}。lane 行维护一个序号分配器和一个队头指针。Worker 认领的候选集在 SQL 层面即被限定为各 lane 的队头。
JOIN pc_work_lanes
  ON pc_work_lanes.lane_key = pc_work_items.lane_key
 AND pc_work_lanes.head_sequence = pc_work_items.lane_sequence
工作进入终态时,同一事务将队头推进至该 lane 的下一条非终态工作。同一 scope 的 Memory 窗口因此严格按序推进。不同 scope 之间、Memory 与 Experience 之间的 lane 键不同,可以并行执行。
失败时 lane 停止前进。终态失败的工作仍占据队头,后续窗口排队等待运维处理。这是刻意保留的行为。Memory 游标乱序推进在领域层面没有意义,跳过坏窗口继续执行只会把错误结果写入记忆。阻塞并等待介入,代价更低。
fencing token
租约机制无法排除一类经典故障。进程因 GC 停顿或网络分区错过续约,恢复后仍以旧持有者身份写入。应对手段是 fencing token。租约每次易主,fence 单调加一,所有写路径强制校验精确的 owner 与 fence。
async def acquire_lease(self, connection, *, lease_name, owner_id, lease_seconds):
    now = await database_now(connection)
    row = await _lock_or_create_lease(connection, lease_name, now)
    if current_owner == owner_id and current_expiry > now:
        fence = current_fence          # 续约,fence 不变
    elif current_expiry is None or current_expiry <= now:
        fence = current_fence + 1      # 易主,fence 加一
    else:
        return None                    # 他人持有且未过期
Scheduler 每次入队、每次保存扫描位置,都在同一事务内以 assert_lease 重新校验 owner、fence 与数据库时间。备用 Scheduler 以更高 fence 完成接管后,旧持有者的下一次写入必然触发 StaleCoordinatorLeaseError。Worker 侧采用对偶机制,心跳、失败记录、最终提交,都要求行上的 owner、fence、attempt 三元组与持有的 claim 完全一致,任一不符即抛出 StaleWorkClaimError。
fence 使"租约过期后接管"这条恢复路径在并发条件下成立。缺少它,主备切换的正确性只能依赖时序概率。
执行至少一次,提交至多一次
涉及外部模型调用的执行不存在 exactly-once。Worker 可能在模型返回之后、提交之前宕机。合同如实表述为,执行至少一次,提交至多一次。它依靠两条规则成立。
第一条,provider 调用不持有数据库事务。Worker 的 prepare 阶段在事务外读取窗口数据、调用模型、获得结果。一次模型调用持续数十秒,长事务持有行锁等待它,会把外部服务的不稳定性传导为数据库的锁竞争。
第二条,所有涉及多个对象的变更收敛进最后一个短事务。校验 claim 有效,执行领域提交,工作置为 succeeded,关闭 attempt 记录,释放逻辑键,推进 lane 队头。这些动作在同一事务内完成,整体提交或整体回滚。
async with self._database.transaction() as connection:
    completed = await self._repository.complete(
        connection, claim, prepared.result, commit=prepared.commit,
    )
领域提交内部复用既有的游标 CAS。handler 在最终事务中重新锁定游标行,要求当前位置与代际同 payload 封装的窗口边界精确一致,任何偏差都拒绝提交。另设一个幂等出口。被恢复的尝试若发现游标已越过自身的 through,说明前次执行实际已提交成功,仅响应丢失,此时按 already_committed 正常收尾,不视为错误。fence 校验与游标 CAS 共同导出一个保证,一个逻辑 Source 窗口至多产生一个数据库结果。
对数据库能力的最小依赖
整个 Ledger 运行在 OceanBase 4.3.5 的 Read Committed 隔离级别上,且刻意不依赖超出常规语义的能力。
过期判断一律使用数据库时间,即 SQL 的 CURRENT_TIMESTAMP(6)。应用进程时钟仅用于轮询间隔与本地 deadline。多副本部署中节点间时钟漂移是常态,以应用时间判定租约过期,会给一致性引入边界无法界定的风险。
认领不使用 SKIP LOCKED。实现先以索引查询一批到期候选的 ID,上限 max(32, limit*4),再在短事务内按固定锁序逐个锁定 lane、逻辑键、工作行,确认其仍为队头且到期后完成认领。Worker 仅认领与自身空闲执行槽等量的工作,不做预取。
全系统遵循一条锁序,scheduler lease、lane、逻辑键、工作行、领域游标,所有路径按同一方向获取锁,死锁环在构造上被排除。行不存在时的处理也只有一种模式,在唯一键上 insert_if_absent,冲突后重读。
进程角色与对外契约
部署划分四种角色。single_node/all 为默认值,单机用户体验不变。分布式模式下每个进程只能是 api、scheduler、worker 之一。一批无法成立的配置组合在启动前即被拒绝,SQLite、seekdb、role=all、主机本地的 External Skill 目标。此类问题若延迟到运行时暴露即为生产事故,让进程拒绝启动是更安全的默认。DDL 归属独立的迁移账户,powercontext server migrate 执行 Alembic 只进不退的迁移链,分布式角色启动时仅校验 schema revision,不自动执行 DDL。
API 层用户可感知的变化集中在 flush 的异步化。POST /v1/memory/flush 有三种结局。无待处理 Source、或在等待预算内完成,返回 200。工作仍在排队或执行,返回 202 并携带 Location 与 Retry-After。该逻辑键已被失败工作阻塞,返回 409 operation_blocked。配套的 Operation API 提供查询、列表、取消与显式重试,变更请求携带 expected_version 做乐观并发控制,版本不符返回 409。既有 PowerContextClient.flush_memory() 保持同步语义,内部提交后轮询至总 deadline,超时抛出携带 operation ID 的 OperationPendingError,既有调用方无需修改。
分布式模式下 MCP 采用 FastMCP 无状态 HTTP,连续请求可路由至任意 API 副本,负载均衡器不再需要会话亲和。代价是关闭 elicitation 与 sampling 等依赖服务端会话记忆的能力。
可观测性有两条硬约束。指标仅使用有界标签,kind、status、outcome、role、错误类别,scope、principal、work ID 不进入 label。Source 内容、prompt、模型输出、凭据不进入工作行、attempt 行、日志、指标与 trace,持久化错误仅使用有界的 category 与 code 分类。重试的多次尝试以 span link 关联,不伪装为单一连续 trace。
评论
在 GitHub Discussions 中交流。分享你的想法,或补充一个细节。